
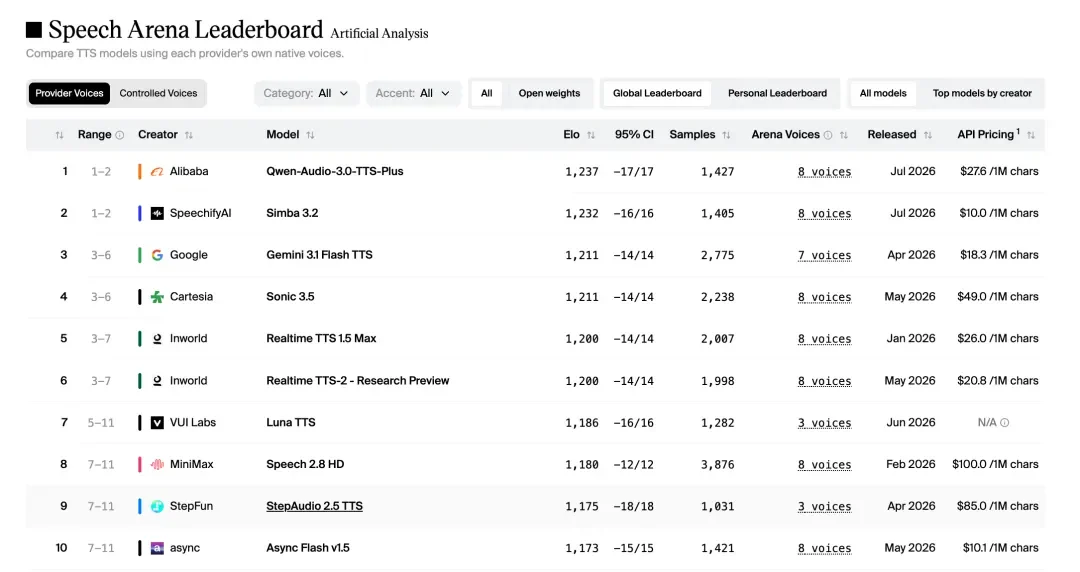
阿里千问于近日正式推出语音合成大模型 Qwen-Audio-3.0-TTS 的全新版本。该模型发布后迅速登上全球第三方权威榜单 Artificial Analysis 榜首,夺得冠军。此次发布包括面向实时交互的 Flash 版本,以及面向高质量生成的 Plus 版本。其亮相意味着国产大模型在语音合成领域的技术实力攀上新台阶,并完成从单纯“能说话”到富有情感地“会表达”的跨越式突破。
音质提升至录音棚水准,阿里千问 Qwen-Audio-3.0-TTS 发布并登顶 Artificial Analysis
作为新一代语音合成标杆,Qwen-Audio-3.0-TTS 在技术层面实现了系统化进步。模型创新性地允许在文本中嵌入结构化标签:用户通过 [gasp]、[giggles]、[angry] 等标记,即可对语气、情绪和呼吸声等细节进行精准调节。借助这种细粒度控制,并配合对 freestyle 指令的出色遵循,合成语音的细腻度显著提高,机器语音由此具备更丰富的情感与表现力。
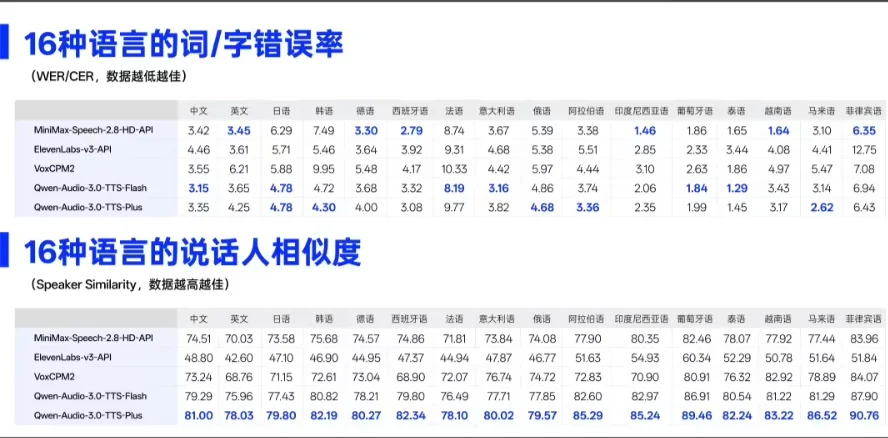
在音质与语种能力方面,Qwen-Audio-3.0-TTS 同样表现全面。其音频输出采样率由 24KHz 提高到 48KHz,单次合成时长最长可达 3 分钟,音质规格可对标录音棚和影视配音级别。同时,模型提供开箱即用的精品音色库,覆盖中文、英文、日文、韩文等 16 种语言,以及广东、四川、东北等 20 种方言,并新增阿拉伯语、越南语等小语种支持,形成面向全球多场景的高质量语音生成生态。
对阿里千问而言,Qwen-Audio-3.0-TTS 的推出是其在多模态大模型领域又一重要里程碑,同时也重新定义了语音合成技术标准。凭借在 Artificial Analysis 榜单上的夺冠表现,以及在音质、控制力与多语种支持上的全面突破,该模型必将推动智能客服、有声读物、游戏配音等应用场景实现革命性体验升级。
评论 0