
字节跳动Seed官方日前推出Seed Audio 1.0音频创作模型,并将其定位为覆盖全场景的影视级创作引擎。该模型在统一框架内对人声、音效与环境声进行联合建模,打破了过去声音只作为画面附属的固有模式,使“听见”与“看见”同步构成沉浸式叙事体验,并推动AI音频生成技术取得明显进展。
字节Seed正式推出Seed Audio 1.0音频生成模型,精细化时间编排能力落地
Seed Audio 1.0的核心优势体现在对音频要素的精细化编排上。用户只需提供一条prompt,就能统一安排对白、音效与环境声,并可沿时间线精确控制声音进入的时点,实现多要素协同运作。与此同时,该模型支持文本和参考音频输入;在长音频生成过程中,角色音色能够保持一致与稳定,同一音色也可自然呈现不同语气和情绪,从而显著增强创作自由度与专业度。
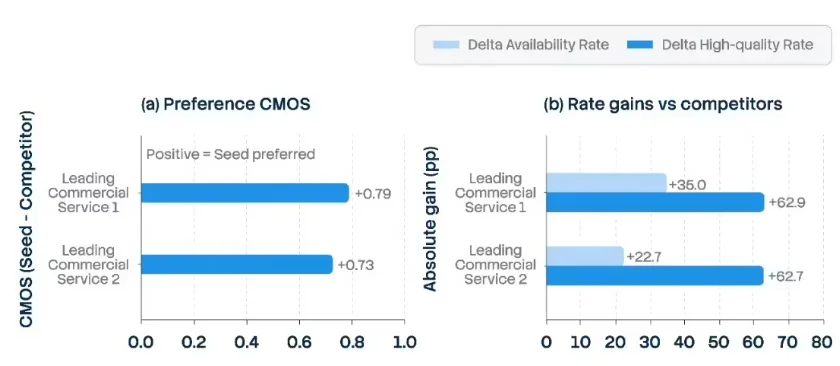
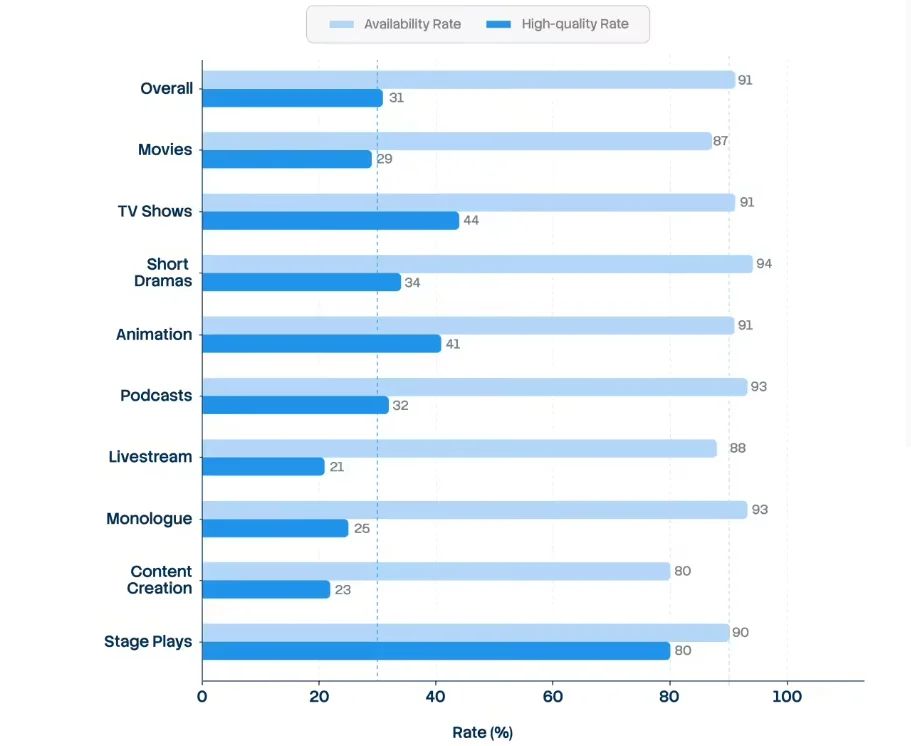
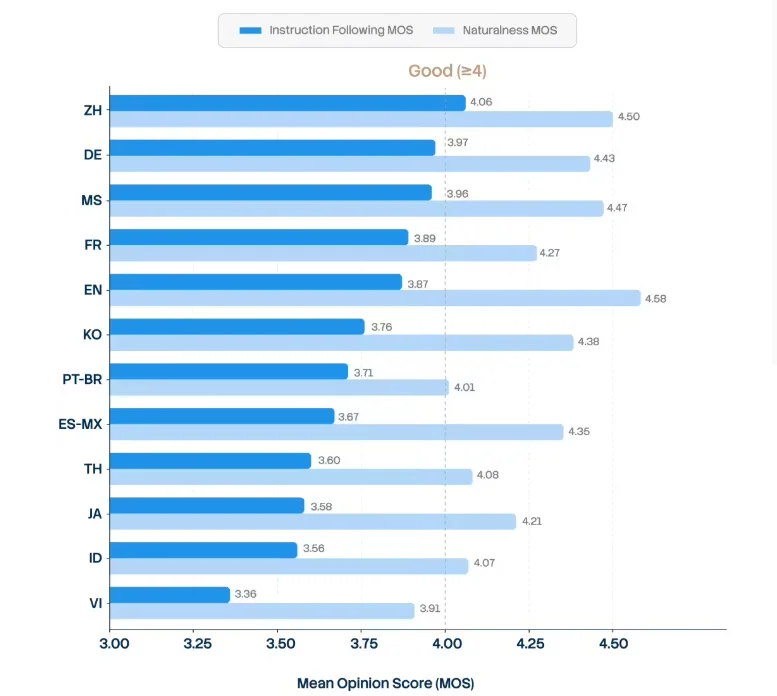
在多语言支持方面,Seed Audio 1.0同样表现突出:目前可生成20个语种的音频,并能结合不同语言的特点调节发音节奏。官方评测数据显示,在影视、短剧、播客等多种场景中,其音频可用率超过90%,多语言音频自然度MOS评分普遍高于4分,这体现出其出色的音质水准和较强的指令遵循能力,可满足专业级创作的高标准要求。
总体来看,Seed AUDIO 1.0的发布是字节跳动在音频生成领域取得的一项重要突破。该模型不仅弥补了长时音频稳定性方面的技术缺口,还通过多要素统一编排和多语言支持,明显降低了影视级音频制作门槛。随着该模型推广应用,音频内容创作将突破现有边界,并有望在效率与创意两个层面实现跃升。
评论 0